Predição de Doenças Crônicas com Determinantes Sociais da Saúde
Trabalho de conclusão de curso: arquitetura preditiva que mede quanto os determinantes sociais da saúde mudam a predição de hipertensão — e a que custo de equidade.
Telas do projeto
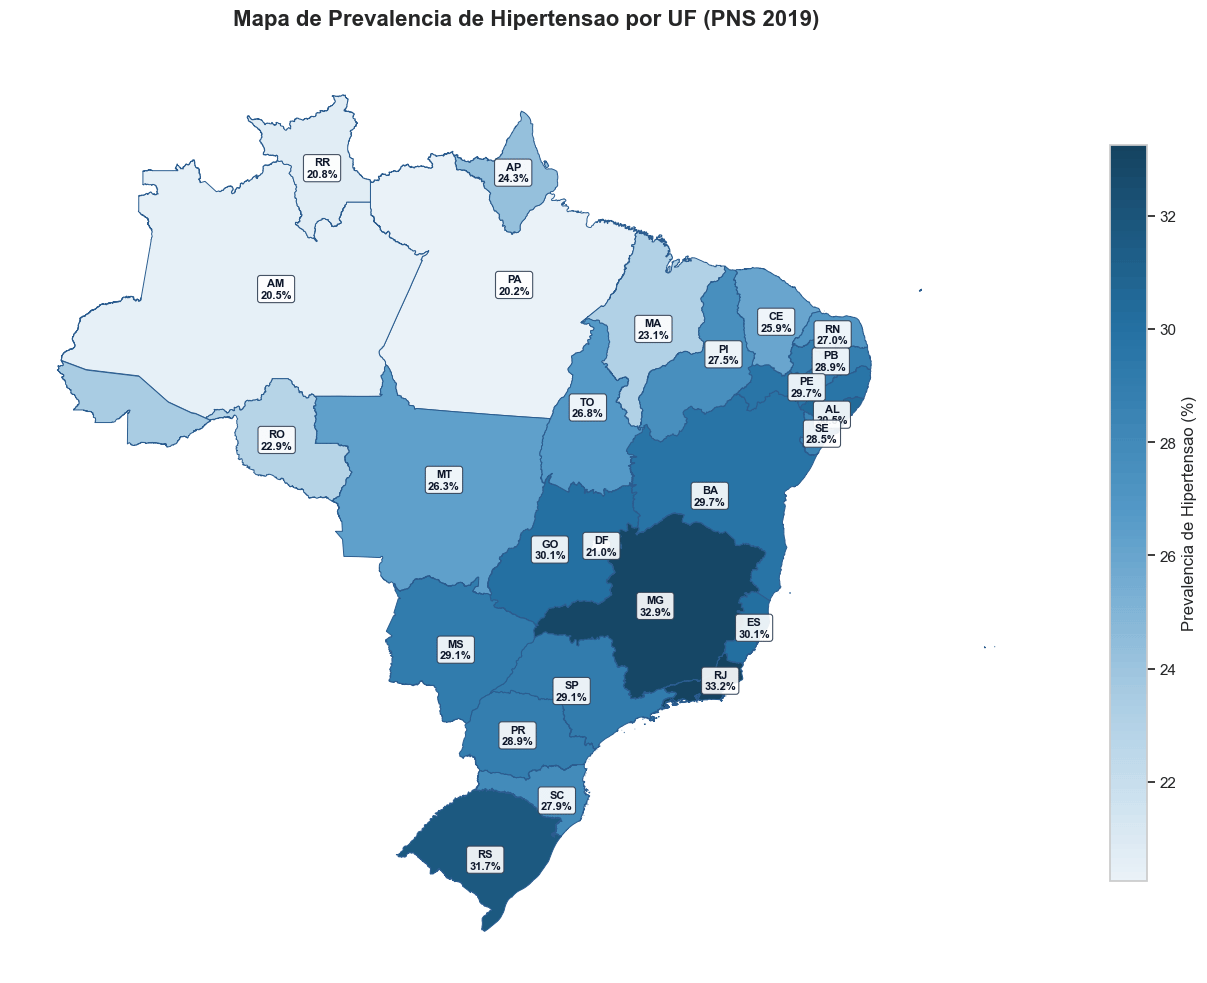
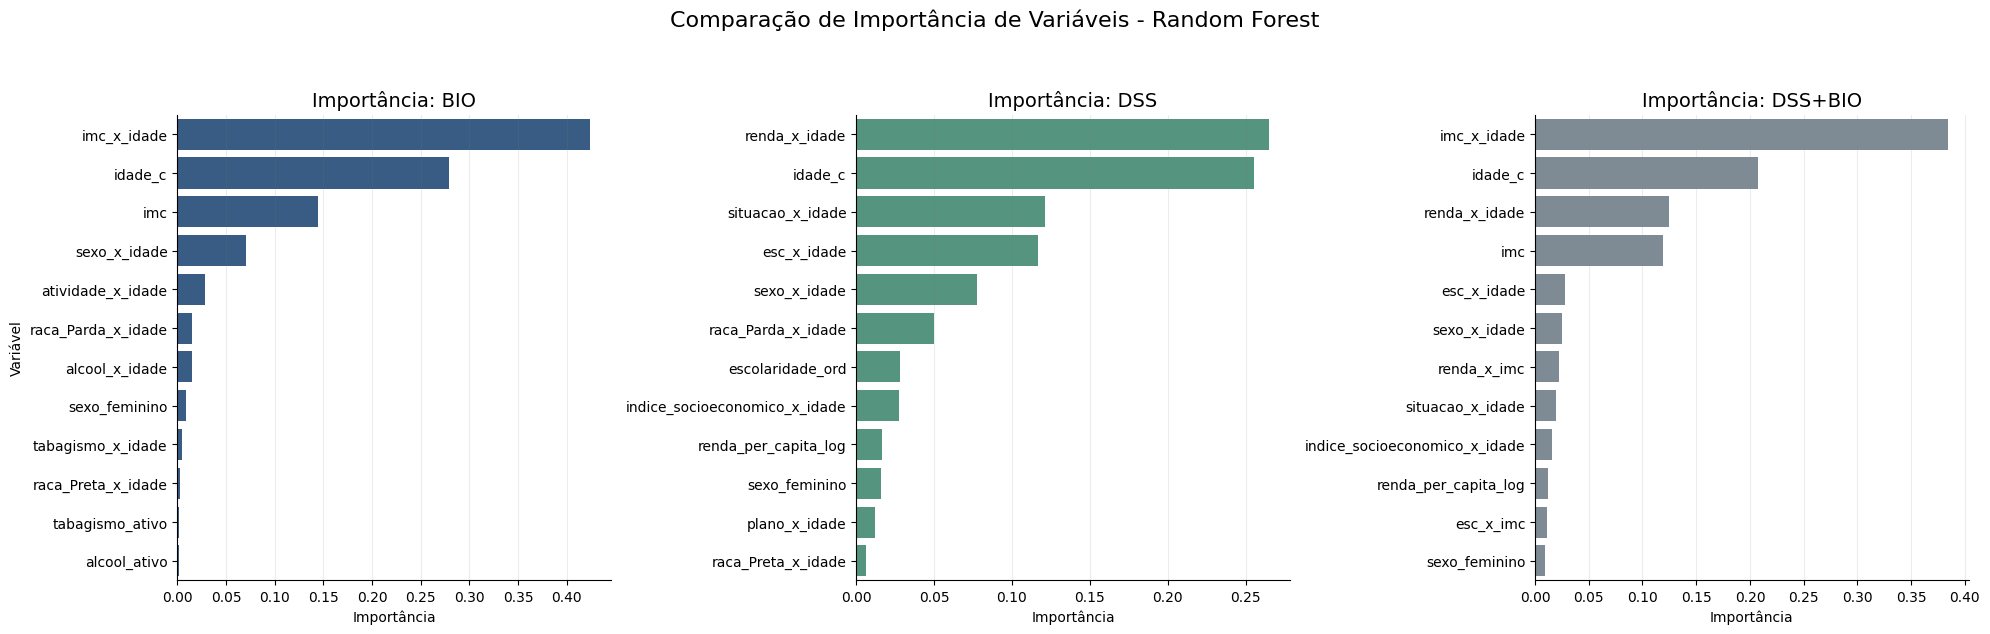
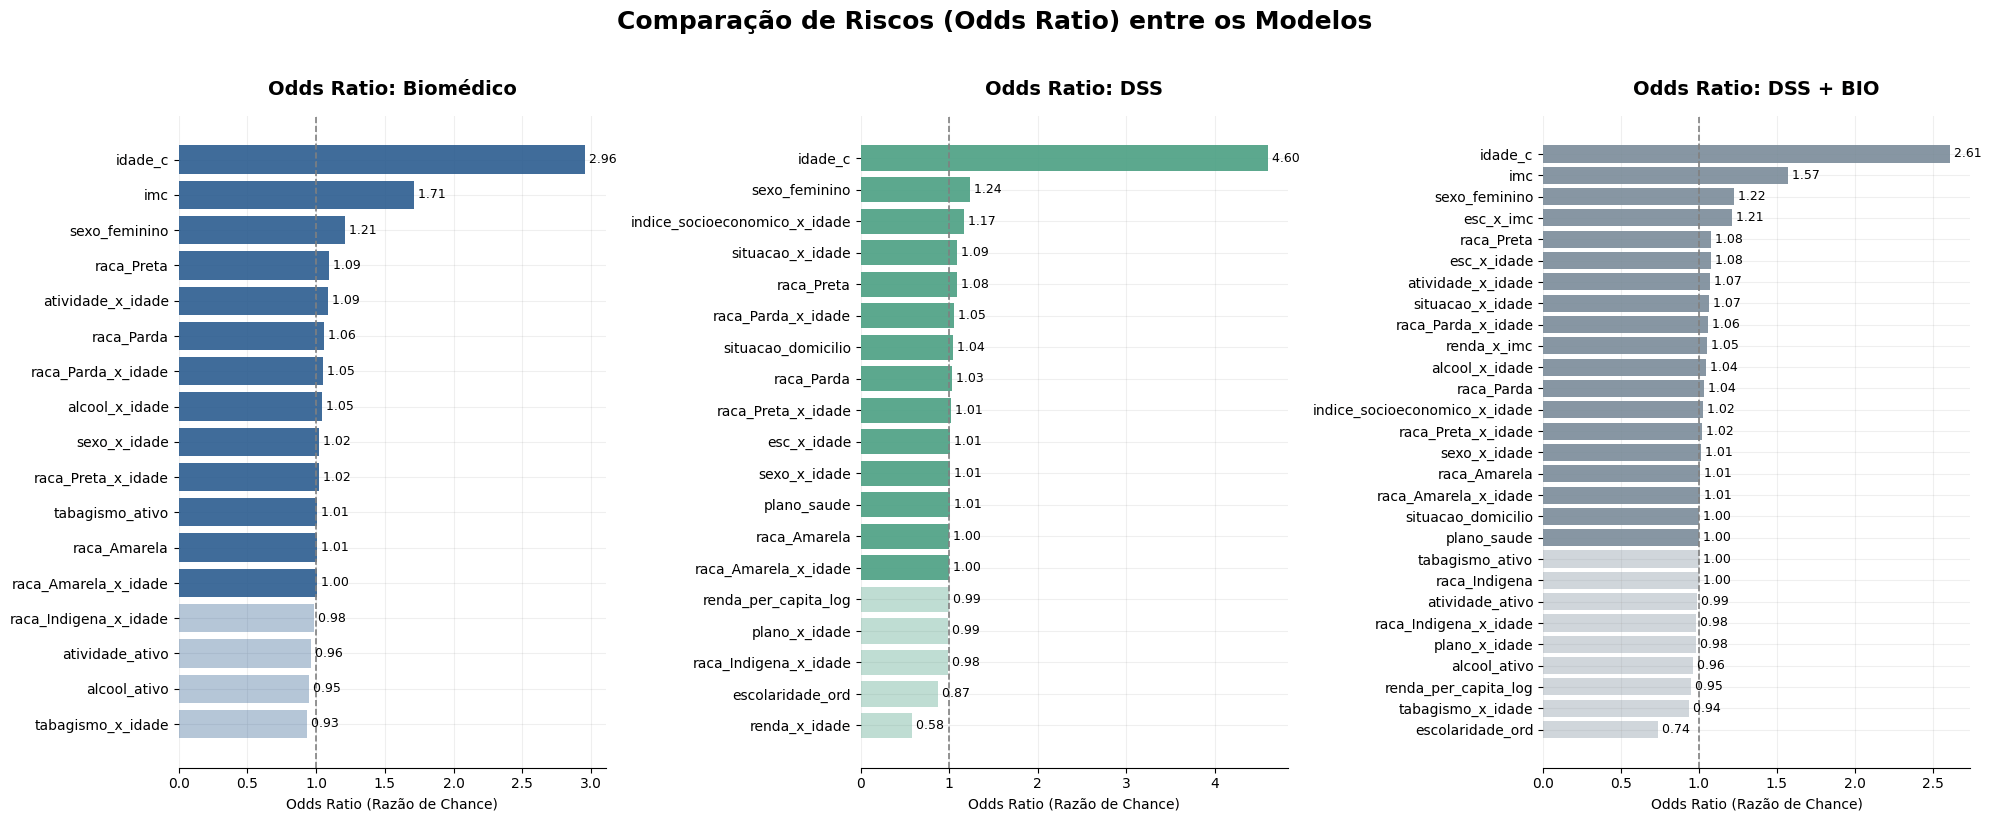
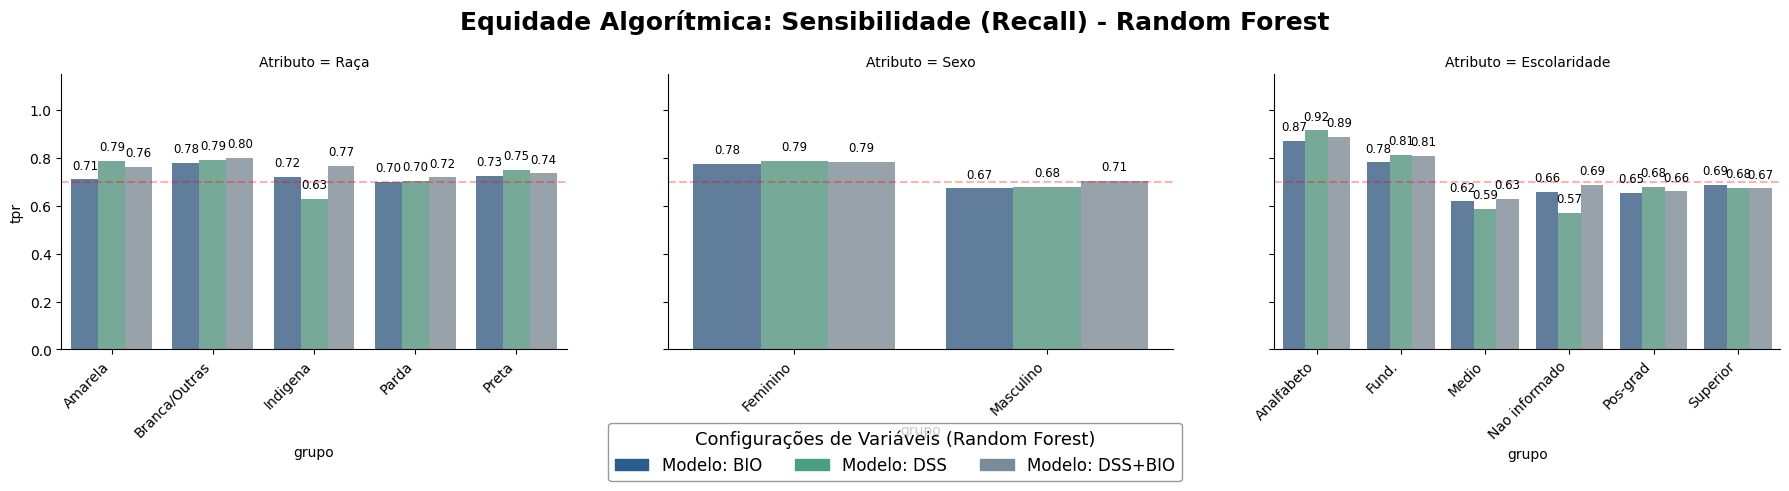
Problema
Modelos clínicos ignoram escolaridade, renda e condições de vida. Isso pode melhorar a acurácia, mas também pode esconder viés: um modelo que acerta mais no agregado pode falhar de forma sistemática nos grupos mais vulneráveis.
Visão geral
Usei os microdados da Pesquisa Nacional de Saúde (PNS 2019) e o processo de Knowledge Discovery in Databases (KDD) para preparação, análise e modelagem. Comparei Regressão Logística com regularização LASSO contra Random Forest em três cenários — biomédico, social e integrado — para isolar a contribuição das variáveis sociodemográficas. Os modelos integrados alcançaram AUC próxima de 0,80 e recall de aproximadamente 75%, mantendo capacidade discriminativa mesmo com a inclusão dessas variáveis.
Decisões técnicas
- Separar os cenários biomédico, social e integrado em vez de jogar tudo num modelo só: sem isso não dá para atribuir ganho ou perda a um grupo de variáveis.
- Comparar um modelo interpretável (Regressão Logística com LASSO) com um ensemble (Random Forest) para saber se a complexidade extra paga o que promete.
- Medir equidade junto com acurácia: Odds Ratio, Feature Importance e métricas de fairness, não só AUC.
- Reportar a diferença de desempenho entre grupos de escolaridade, porque o número agregado esconde exatamente o que a pesquisa queria mostrar.